指示出しでAI疲れしないためのAIエージェントの働かせ方

少なくとも自分の見える範囲では WebアプリケーションはClaude CodeやCodexといったコーディングAIエージェントを使って開発することが当たり前になった。

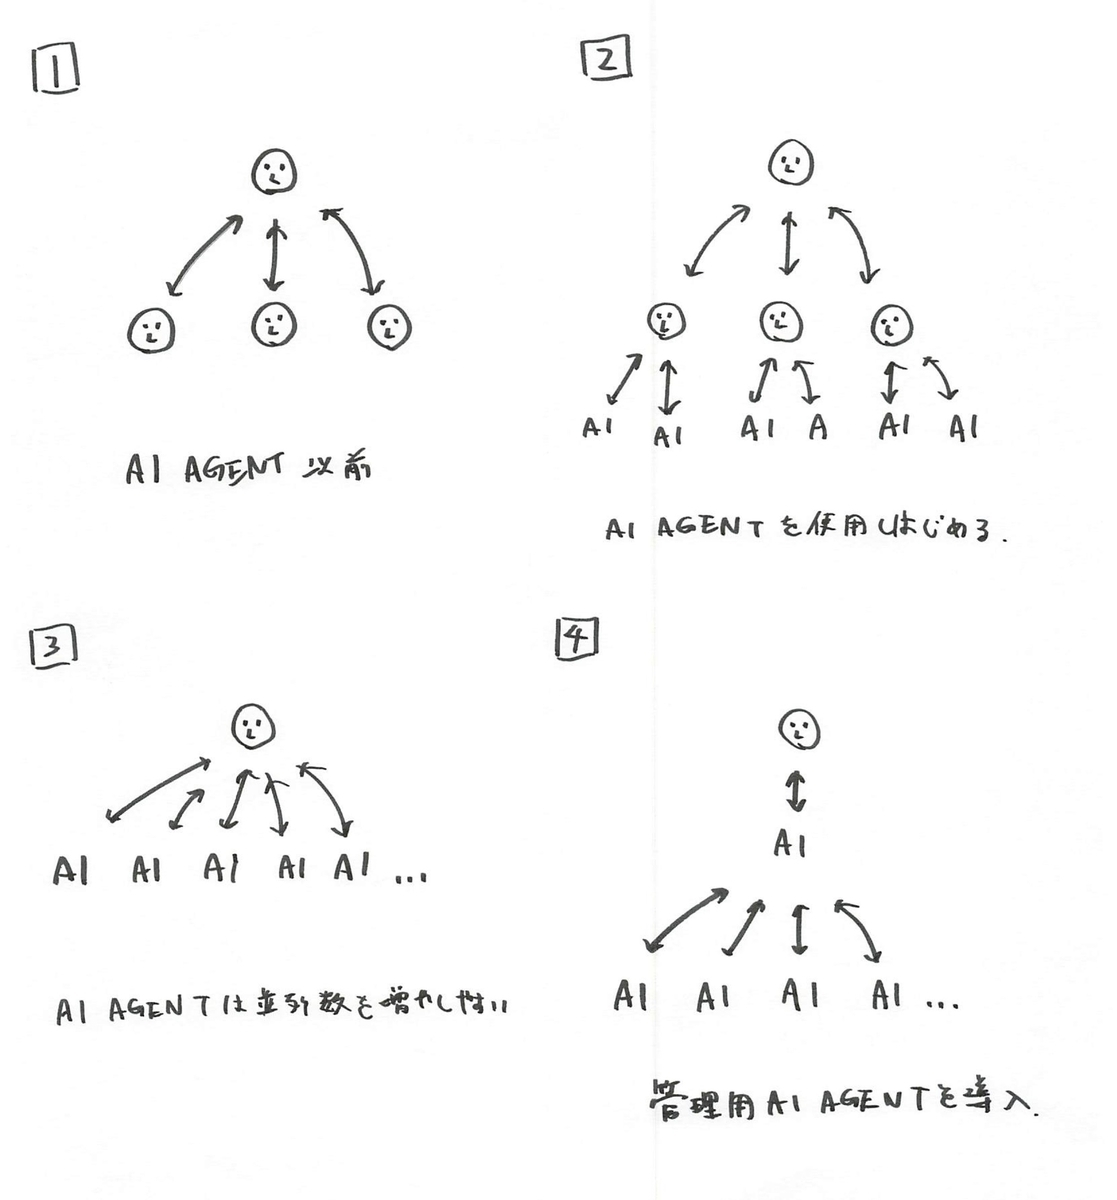
AIエージェントのセッションはいくらでも並行して増やせる一方で、ひとりの人間の処理能力は比較的小さいので、人間がボトルネックになっている。

延々とAIへの指示を繰り返すのは疲れてしまうので、どうにかしようと試行錯誤している。今のところは、AIエージェントの作業セッションと管理用セッションを分けて、管理用セッションが多くの場合に人間と作業セッションの中間に入ることで人間の負荷を抑えている。

最近の変化

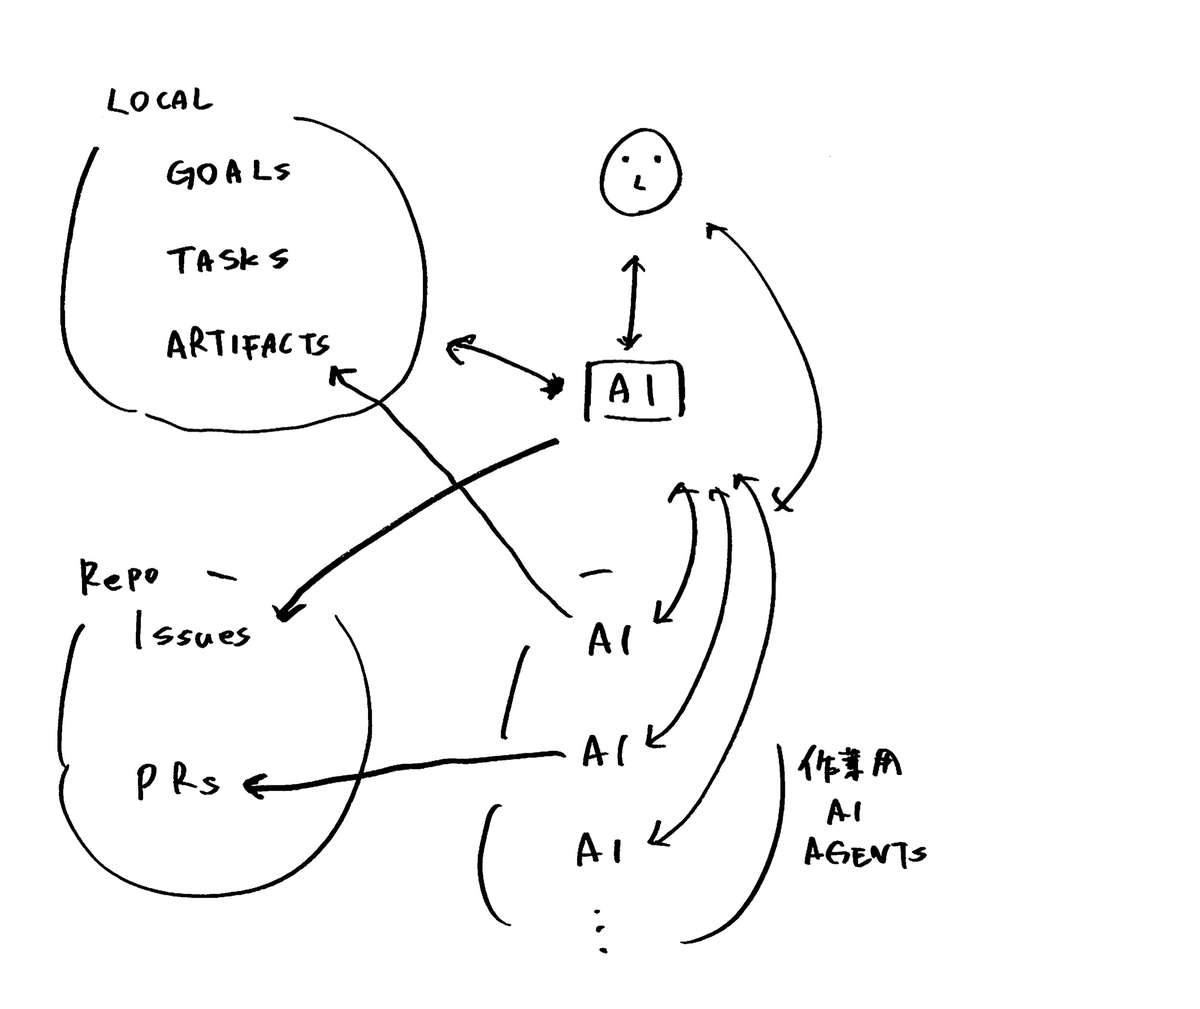
管理用セッションに直接指示を出すだけではなく、ある程度自律的に行動できるようにしたい。そこで管理用セッション用に長期的なゴールを記述する goals.md とタスクを記述する tasks.md を用意して、次のタスクをある程度選べるようにしている。

今は以下のような感じで暮らしている。

こういう感じで暮らしている

GitHubのIssueやPRを使うことはAI以前とは変わっていない。人間のかわりにAIが作業することが増えただけだ。

細かいところで言うと、artifacts ディレクトリはPR以外の成果物を保存する場所にしている。調査とか、けっこうPRを作る以外の仕事もある。

作業用セッションに対しては、管理用セッションから指示を出すことが多いけど、人間が直接やりとりすることも少なくない。承認が必要だったり、追加の選択をする判断が必要になることも多い。

これがベストというわけではないだろうけど、過渡期の備忘録として。

シルバーウィークの自由研究 小説を圧縮して距離を測ってみた

圧縮することで2つのデータの「近さ」がわかる。正規化圧縮距離(NCD)という。簡単にいうと2つのデータを一緒に圧縮し、高圧縮できるほうが近くて、そうでない場合は遠いとする方法で、どんな種類のデータにも適用できる。面白そうなので、小説をいろいろ圧縮してみた。

青空文庫+Web小説

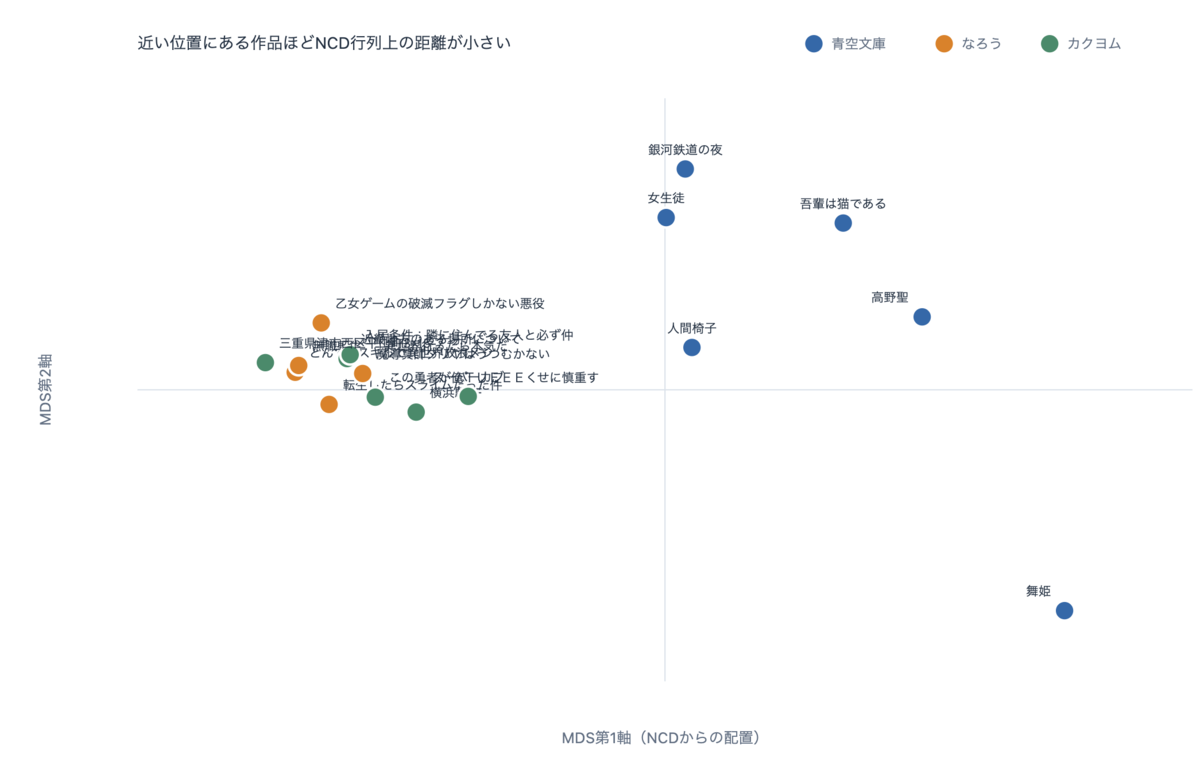
小説は全文ではなく冒頭・中盤・終盤をサンプリングし、圧縮器にはNode.jsの deflateRawSync を使用した。

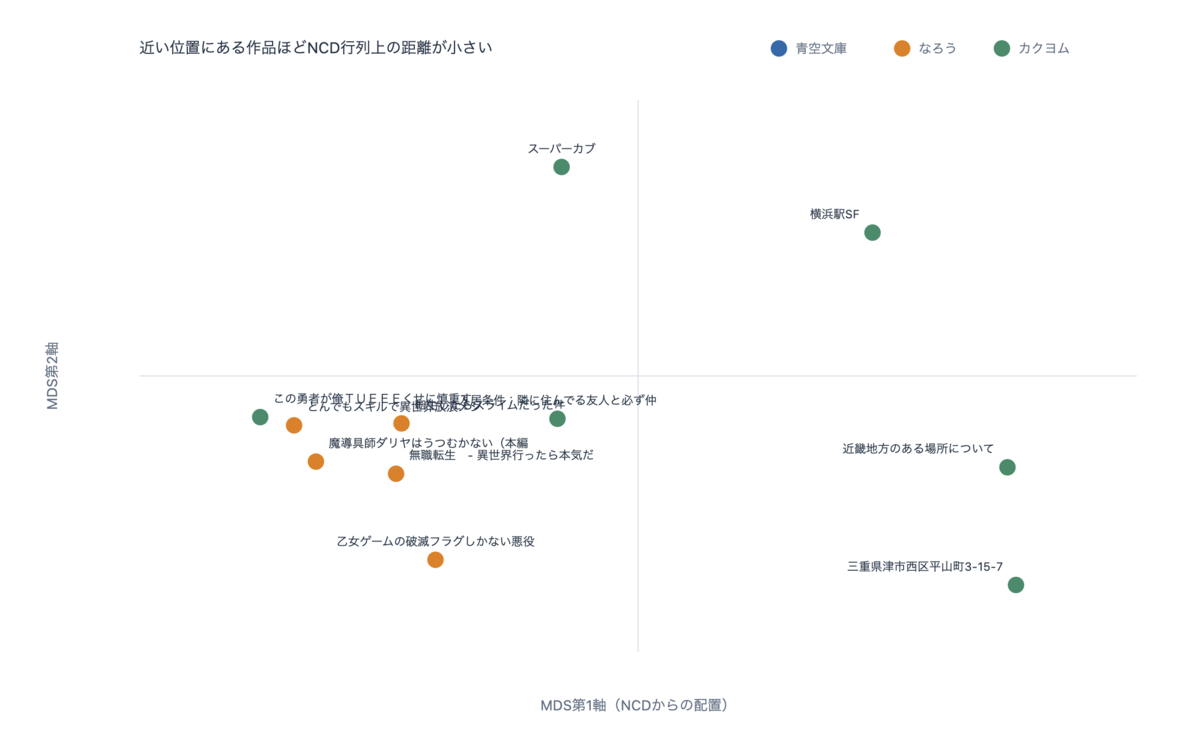
Web小説の作品がそれぞれ距離が近くて固まって見える一方で、青空文庫のデータは離れている。特に舞姫が遠い。

Web小説のみ(修正前)

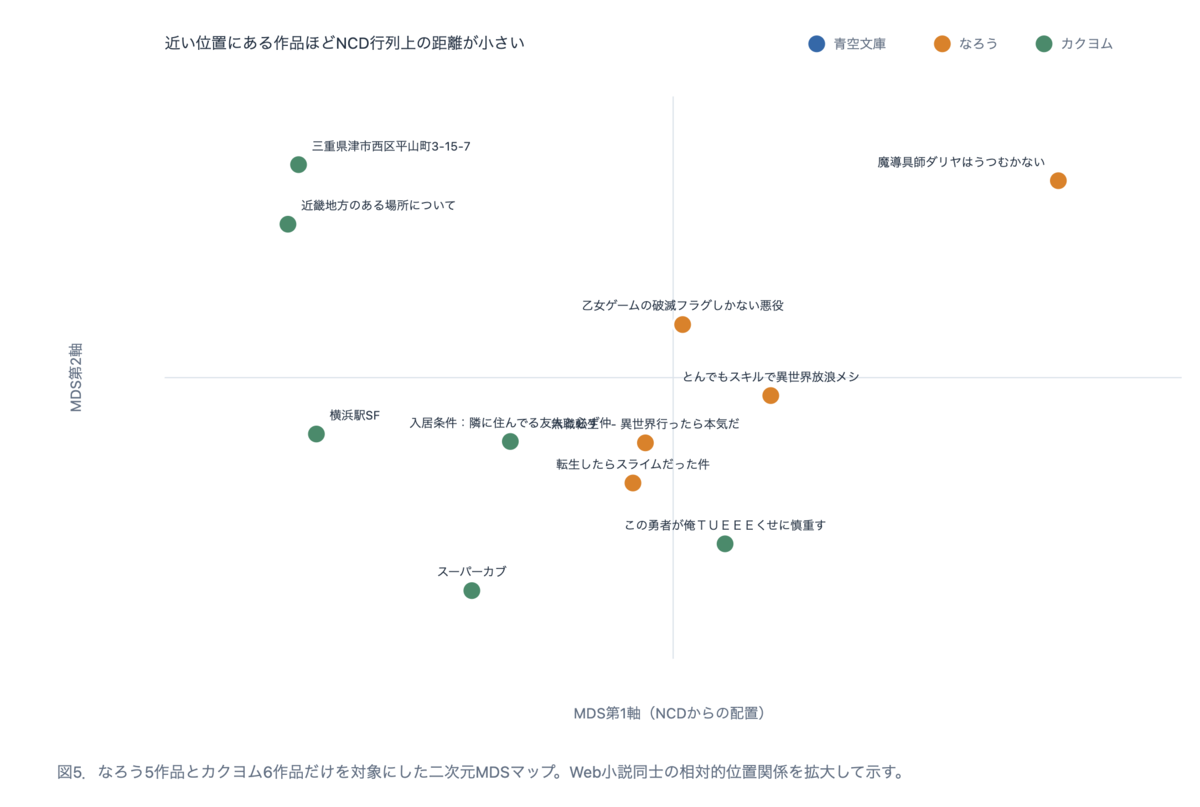
青空文庫のデータがあると、Web小説のデータの差がわからないので、青空文庫のデータを取り除いたプロットも作った。ちなみに以下のプロットには1点違和感があったので、後で修正した。修正版も下に掲載している。

ホラー作品の近畿地方、三重県が近いのは違和感がない。無職転生と転生したらスライムだった件も同じ異世界ファンタジーということで近いのは納得。概ね同じジャンルのものは近くプロットされている。

魔導具師ダリヤがほかと離れているが気になる。女性主人公だからとかと思い、追加で女性主人公作品を1つ追加した。しかしそれでも他のweb小説と大きく離れている。調べてみると冒頭が通常の1話ではなく登場人物一覧だった。固有名詞も多いので、この影響だろう。

Web小説のみ(修正後)

ということで、ダリヤのデータを1話から始まるデータに修正した。するとその他の異世界ファンタジーと近い位置にプロットされた。

修正後

異世界ファンタジーの正規化圧縮距離が小さいのは、設定や語彙に共通のものが多いからだろうか。今回のWeb小説の作品サンプルに異世界ファンタジーが多いからそう見えているだけかもしれない。ホラーの2作品も近い。SFは1作品しかない。サンプル数を増やすと、言えることが増えそうだ。

文章の意味には全く触れないで、こういう分析ができるのは面白い。

LLMアプリケーションにおけるモデル更新の難しさ

本稿は、筆者が実施したモデル比較をもとに生成AIを使用して執筆しました。最終判断は筆者が行っています。

LLMを組み込んだアプリケーションでモデルを更新するとき、新しいモデルは「より高性能なのだから、少なくとも現在の挙動は維持される」と考えたくなる。

しかし実際には、モデル更新はライブラリのバージョンアップのような単純な差し替えではない。既存のアプリケーションとの互換性を、改めて検証する作業である。

後継モデルを含む比較構成で会話の評価が下がった

あるチャット機能で、代表的な会話と期待する結果を用意し、LLM-as-a-Judgeで評価している。

現行モデルでは20点満点中19.3点だった評価が、後継モデルを含む比較構成では15.0点になった。後継モデルが一般に低性能だと結論づけたいわけではない。あくまで、既存のアプリケーションとその会話設計に対しては、期待どおりに動かない場面が増えた、という結果である。

同じthinking levelでも、同じ条件ではない

モデル更新で見落としやすいのがthinking levelである。

設定値が同じ名前であっても、モデルが変われば、内部的な推論量や応答の傾向まで同じとは限らない。あるモデルのLOWと、別のモデルのLOWを、同じ実行条件として扱うことはできない。

さらに、プロンプトも中立な仕様書ではない。現在のモデルがどの程度指示に従うか、どのような場面で補足質問をするかといった振る舞いに、知らず知らず適応している。後継モデルでは、同じプロンプトでも会話の進め方が変わり得る。

つまりモデル更新とは、モデル名だけの変更ではない。モデル、thinking level、プロンプトの組み合わせを更新する作業である。

モデル提供者自身も、世代移行時には自分たちの評価セットで推論設定を改めて検証することを勧めている。Anthropic: Model migration guide

評価は「正解」を決めるものではない

今回の評価にはLLM-as-a-Judgeを使った。ただし、そのスコアを品質の絶対値とは考えていない。

LLM-as-a-Judgeには、冗長な回答を好む傾向や、比較順序に影響される傾向などの限界がある。Zheng et al., 2023 評価基準自体が現行モデルの振る舞いに過度に適応している可能性もある。

だから、スコアが下がっただけで結論は出せない。評価で差分を見つけ、失敗した会話ログを人間が読み、実際に意図した会話フローから外れているかを確認する必要がある。

それでも自動評価には価値がある。人間の印象だけでは見落としやすい変化を、同じ条件で繰り返し検出できるからだ。評価は採点機ではなく、調査すべき回帰を知らせる検知器として使うのがよい。

モデル更新時に確認すること

モデル更新では、次の単位で比較する。

  • モデルとthinking levelの組み合わせ
  • その組み合わせに対するプロンプト
  • 代表的な会話での評価結果
  • 失敗した会話ログと、その原因
  • ユーザーが実際に望む体験との一致

ユーザーと開発者の(人間による)フィードバックを取り入れる

複雑な会話品質では、事前に用意したevalだけで正解を定義しきれない。開発者による会話ログのレビューだけでなく、リリース後にユーザーから得られるフィードバックも重要である。

フィードバックから見つかった問題は分類し、次回のモデル比較で確認できる代表的なテストケースとして追加する。自動evalは人間の判断を不要にするものではない。実利用で得た問題を継続的に検証できる形へ変えるための仕組みである。

GWの自由研究

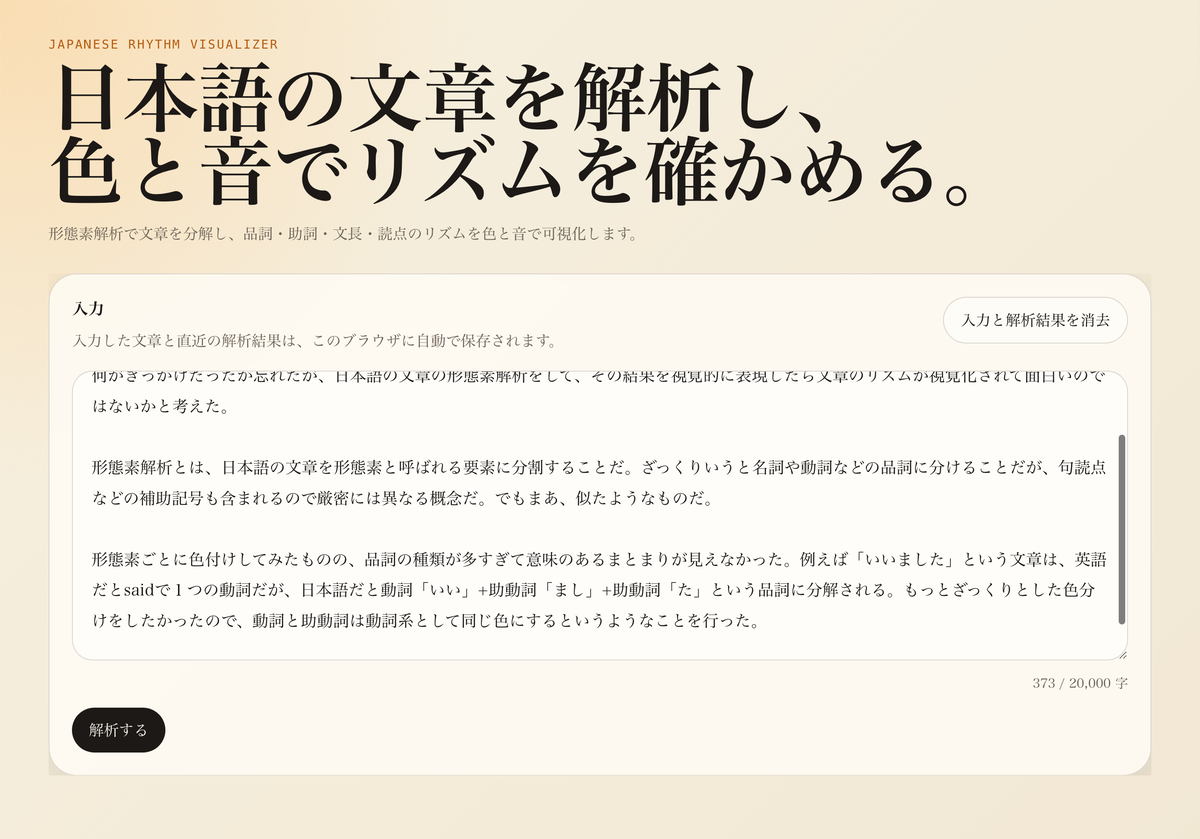
何がきっかけだったか忘れたけど、日本語の文章の形態素解析をして、その結果に色を付けて表示したら文章のリズムが視覚化されて面白いのではないかと考えた。

形態素解析とは、日本語の文章を形態素と呼ばれる要素に分割することだ。形態素とは名詞や動詞などの品詞に加えて、句読点などの補助記号も含まれる概念のようだ。日本語の形態素解析は公開されているライブラリを使うことで簡単に試すことができる。

ということでGWの休みを利用してやってみた。ChatGPT PlusプランでCLIコーディングエージェントのCodexが使えるので、ほとんどのコーディングはCodexがやっている。主に使用したモデルはgpt-5.5だ。

色をつける

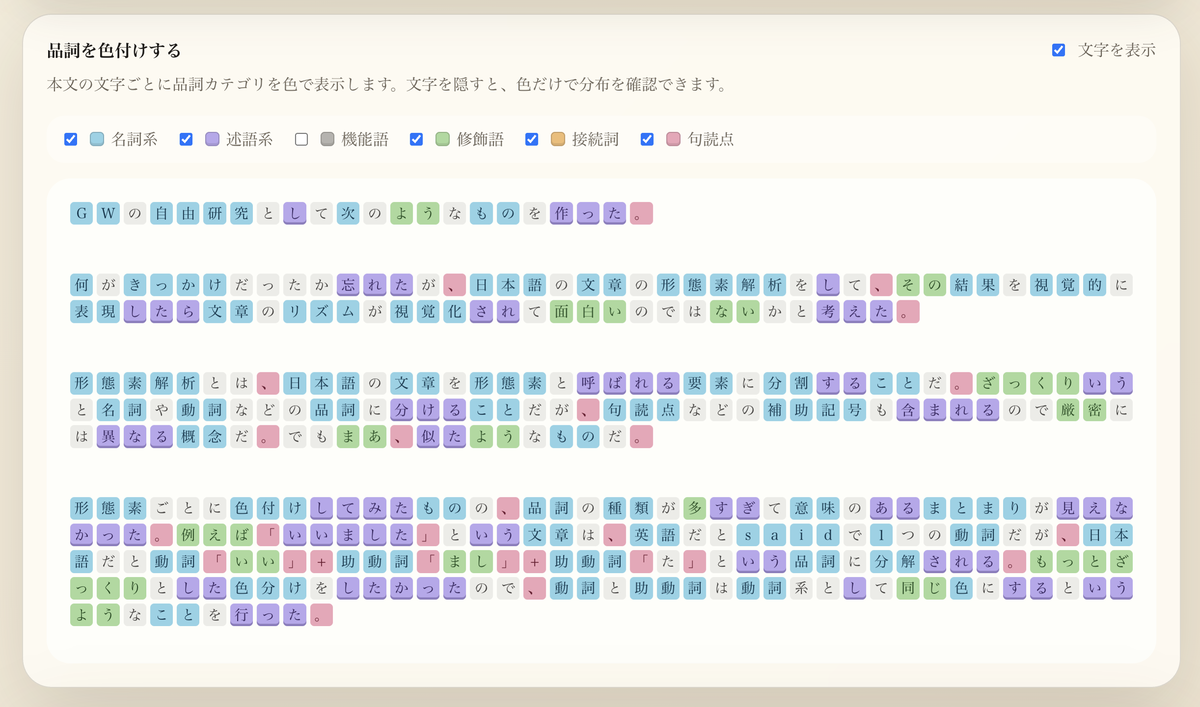
最初にできたものでは形態素ごとに色付けしていた。しかしそれでは品詞の種類が多すぎて意味のあるまとまりが見えなかった。例えば「言いました」という文章は、英語だとsaidで1つの動詞だが、日本語だと動詞「言い」+助動詞「まし」+助動詞「た」という品詞に分解される。もっとざっくりとした色分けをしたかったので、動詞と助動詞は動詞系として同じ色にするというようなことを行った。 その結果、名詞系、述語系、機能語、修飾語、接続詞、句読点の6色で色付けするものが出来上がった。 6色ぐらいというのはちょうどいい数だ。 接続詞というのは意外と使われないな、とか、少し難しい文章になると、接続詞が使われることもあるなというようなことがわかった。

品詞を色付けする

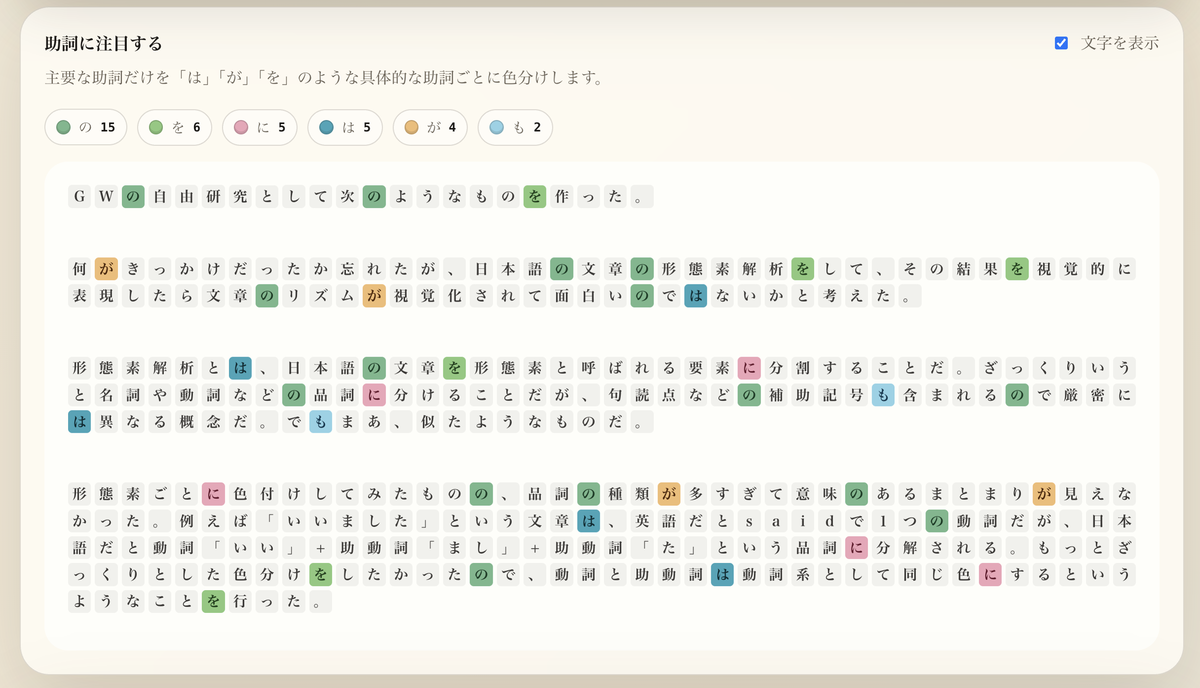
次に助詞に着目した。日本語のリズムというのは、助詞の位置が重要なのではという直感があった。なのでそれを視覚的に表現してみる。 助詞にもいろいろなものがあるので、特に多く使われるものを恣意的に選んで色をつけることにした。

助詞に注目する

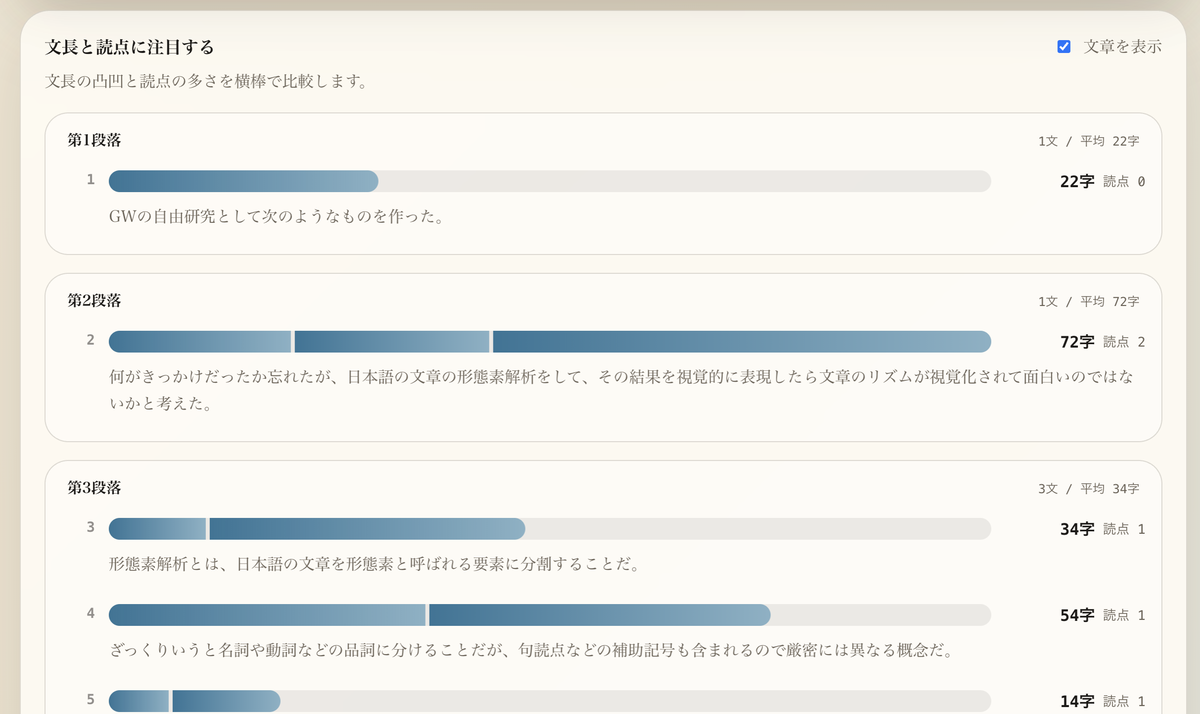
品詞とか関係なく、文章の長さと読点の位置を可視化したりもした。 形態素解析をほとんど使ってないけど。これでも日本語の文章のリズムを把握するには十分使えるのではという印象だ。 だらだらと長い文章の後に、短い文章があったりするとリズム感があっていい、とか。 そういうものだ。

文長と読点に注目する

自分の文章だけではなく、他の人の書いた文章でも試してみた。小説的な文章で、どれくらい修飾語が使われているのかを調べたりした。小説でも意外と修飾語は増えないという印象だった。ジャンルやシーンによっても変化があるのかもしれない。あるライトノベルの冒頭では修飾語が比較的多いという例もあった。

いろいろと見ていくと、文章に色をつけることで構造が見えてきて、動物の骨格標本を見るような面白さがあった。

音をつける

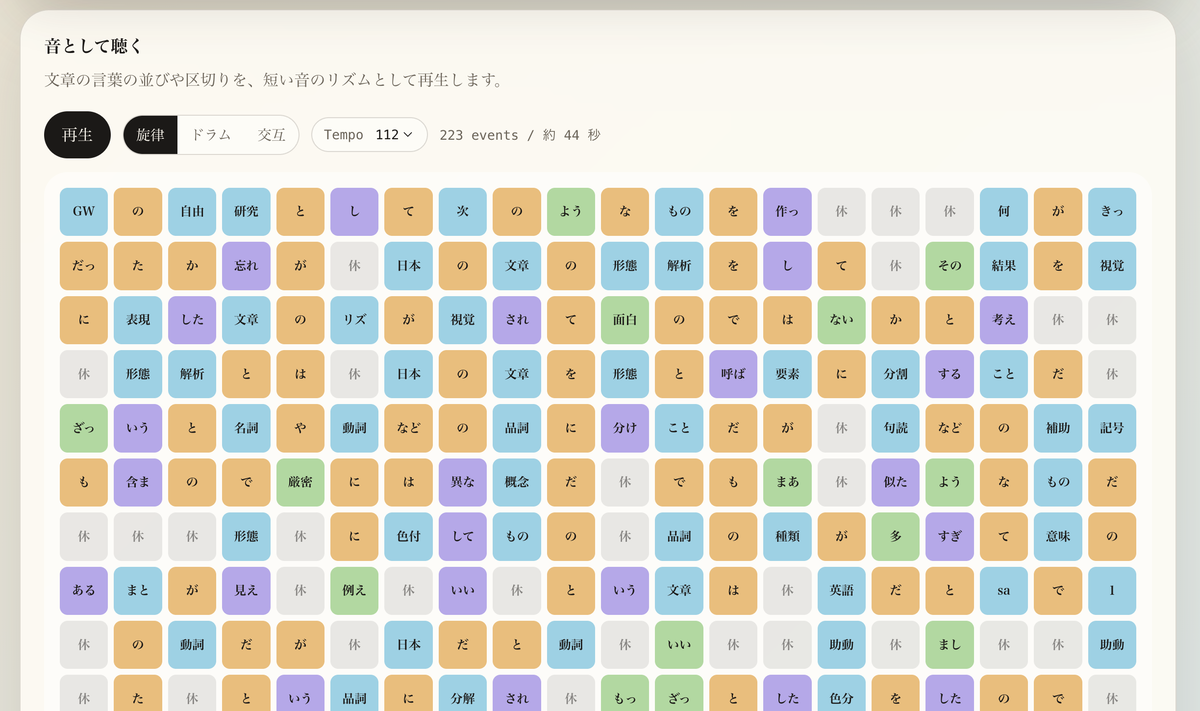
いろいろやってきて、リズムを視覚的に表現するだけではなく音声でも表現したくなってきた。リズムと言ったら音ですからね。日本語の音声的なリズムというよりは、品詞に分解した後にその品詞ごとに音を鳴らすという感じなので、単語の長さは完全に消滅している。なので声に出したときのリズムとは全く違う。でもまあ、それはそれで面白いんじゃないかと思っている。日本語の発話したときのリズムから離れて、構造のみのリズムだ。

メロディっぽい音声で試したが、もっとリズムを強調したくてドラムセットのような音を出せるようにした。その後、変化があったほうが面白いので文章ごとに音声モードを切り替えるオプションも用意した。

音として聴く

デプロイする

せっかくなので作ったものをデプロイしてみた。WebアプリケーションはCloudflare Pagesに、APIサーバーはCloud Runにホスティングしている。APIサーバーは形態素解析のSudachiPyライブラリを使うことができ、APIサーバーを簡単に構築できるPythonを使用した。

以下のURLから触ることができる。

https://jp-morph-viz.pages.dev

Claude CodeでVibe Codingするときになるべく少ない指示回数でタスクを完了させたい

AIがコーディングすると言っても、ある機能を作るために一度指示した後に、何度も確認をしたり、追加の指示をしていては人間がパソコンに張り付いて離れることができない。他のことをしていても何度も戻ってきてはマルチタスクも難しい。できたら最初に指示を出したら、そのまま最後までタスクを行って、完璧に期待通りにこなしたうえで「完了しました」と報告してほしい。

自動運転の車に乗って目的地を告げたら、途中で交差点に入るたびに直進するか曲がるか聞かれるのではなく、目的地まで間違いなく到着した後に「到着しました」と告げられたい。

残念ながらClaude Codeでコーディングしていると、最初のプロンプトでタスクの完了まで行うことはほとんどない。対話型のインターフェースなので別に1つのプロンプトでタスクを完遂させる必要はないが、無駄に何往復もしたくない。コマンドやスキルのようなツール承認を人間が行うことも多い。

Count Interactions

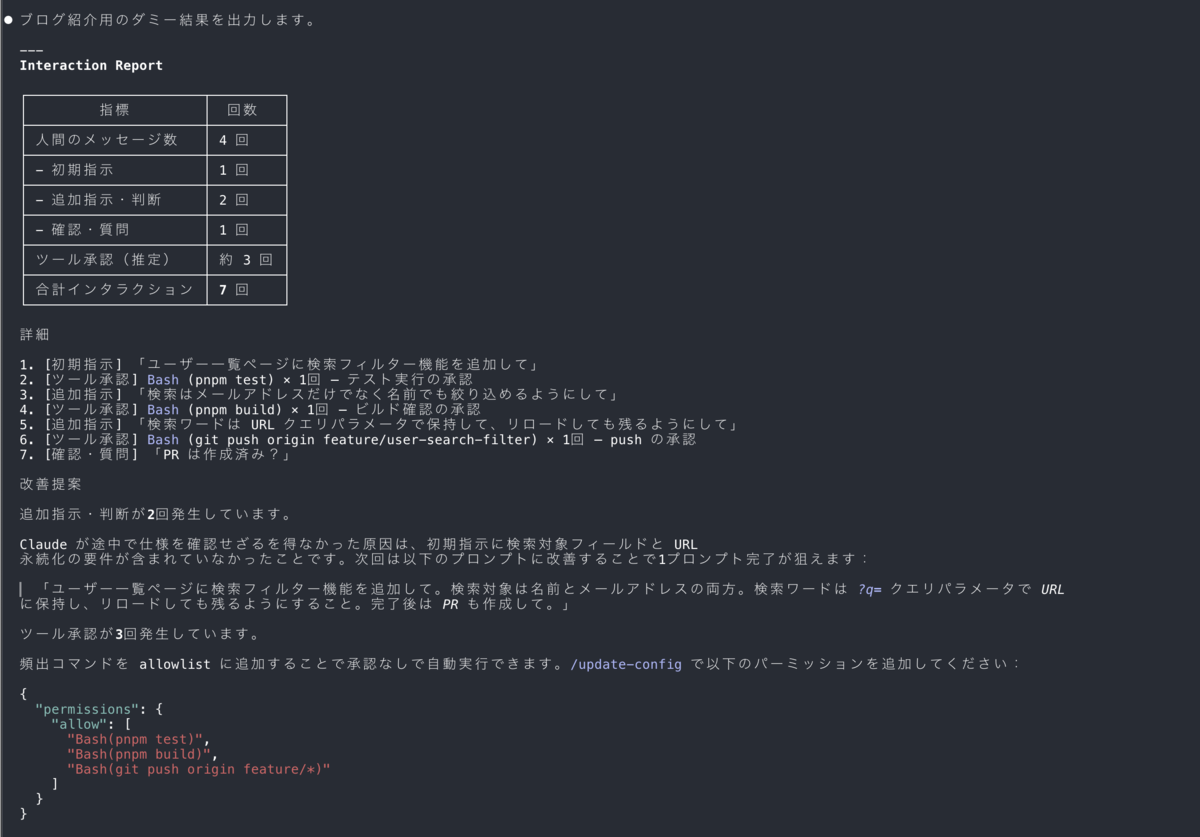
そこで、Claude Codeで何かをした後に、作業をふりかえり人間の指示回数と承認回数を数えることにした。count-interactionsというスキルにして、タスクが完了したあと(大抵はPull Requestをマージした後)に実行している。

以下のような結果になる。

count-interactions スキルのダミー結果

改善するためには初回プロンプトで要件を漏れなく伝えるのが重要だということだ。またツール承認をあらかじめ設定ファイルのallowedToolsに追加して必要な権限を与えておくことも改善に繋がる。なんだか人間に指示を出すときと同じようで面白い。その他にもスキル(Agent Skills)を作ったり、CLAUDE.mdに注意事項を追記しても改善できる。

count-interactions スキルでふりかえりを行う習慣のお陰で、プロジェクトの CLAUDE.md に含まれる冗長な記述や紛らわしい記述(コマンドの例に引数が足りないなど)を改善できてよかった。

Vibe Coding Golf

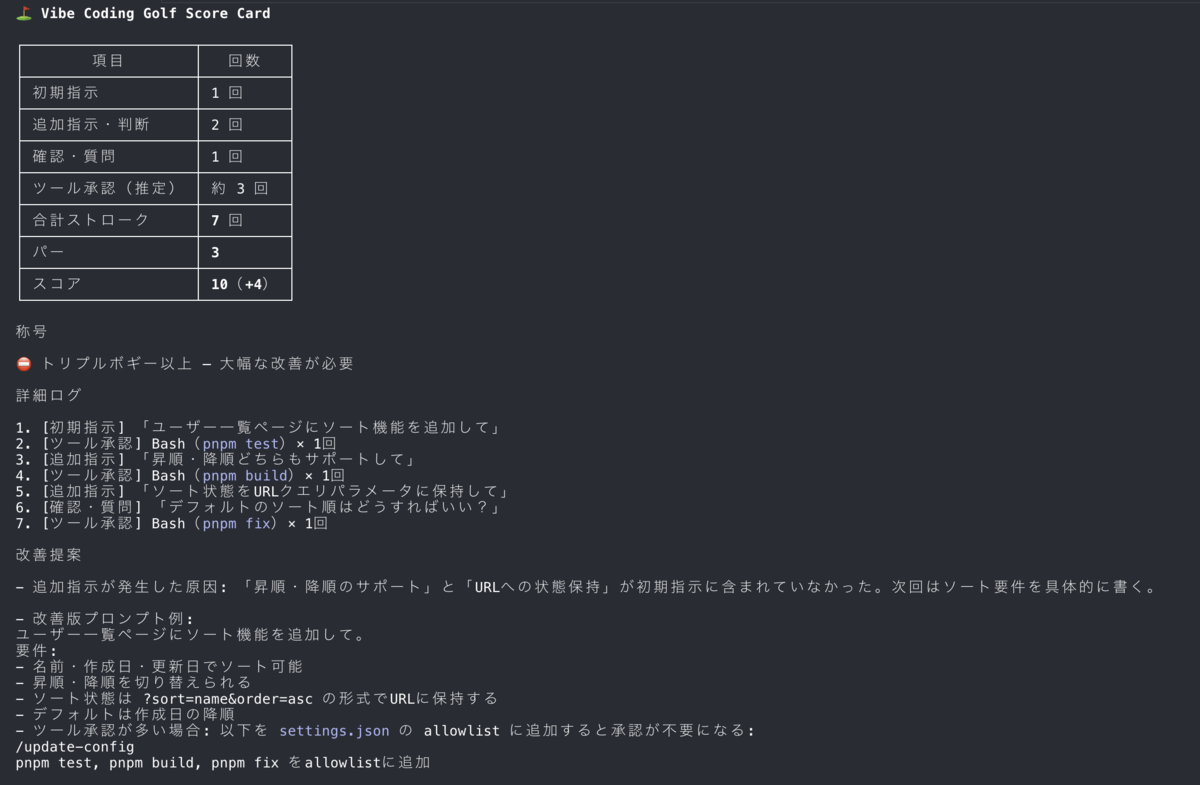
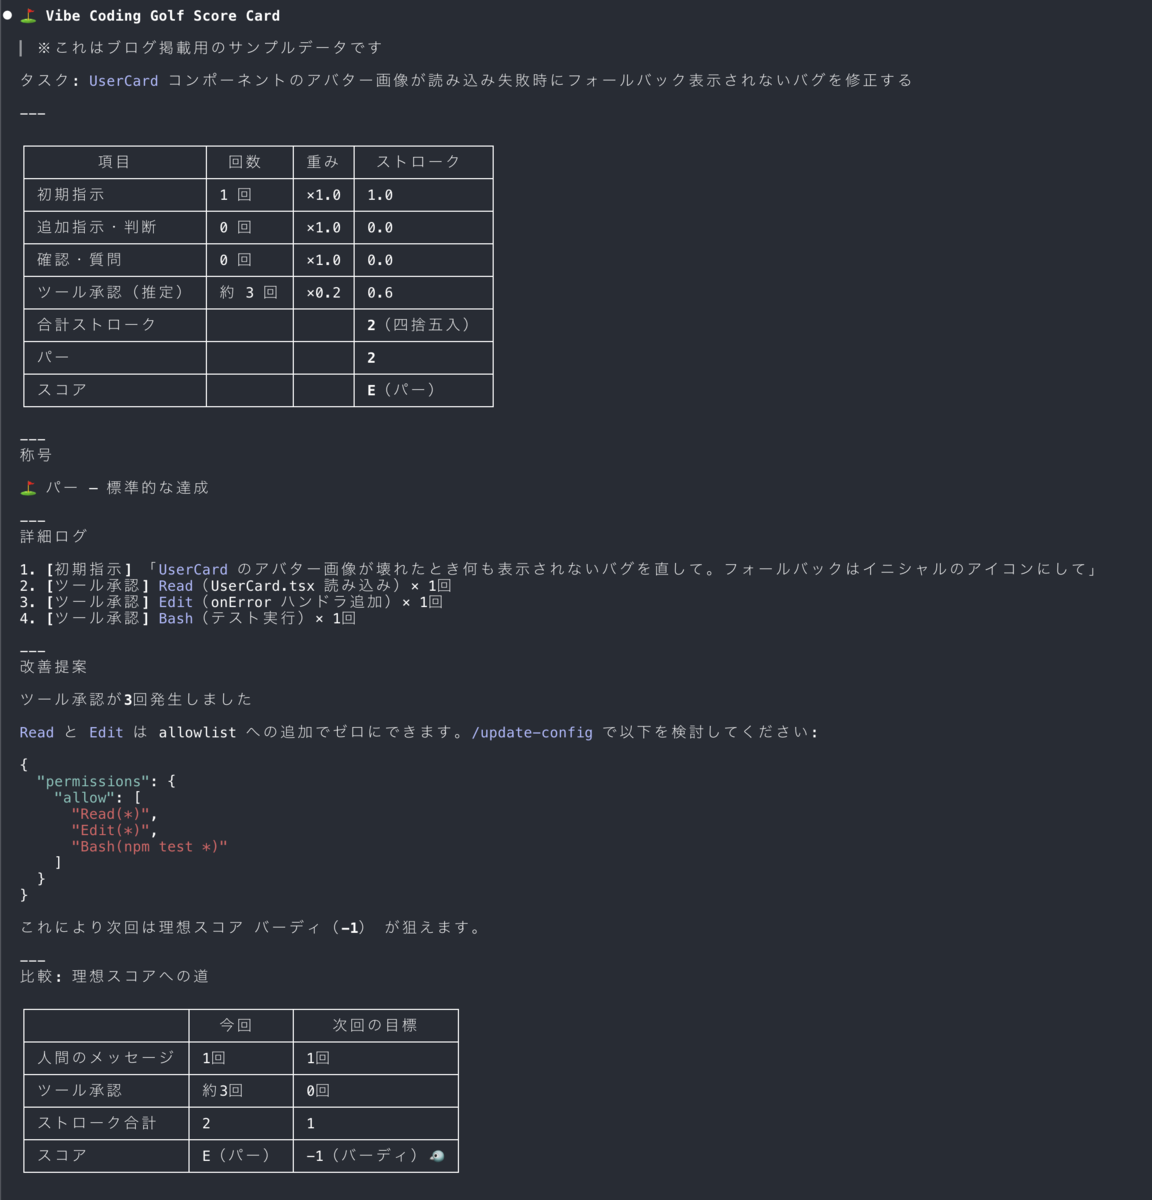
ここまでは仕事の真面目な話だが、ここからは余談。なるべく少ない回数で目的を達成したいという行為がゴルフと似ていると思ったのでcount-interactions スキルをもとにvibe-coding-golfというスキルを作った。基本は同じだが、ゴルフ的な評価をしてくれる。

vibe-coding-golf スキルのダミー結果

何回か試したがボギーばかりだ。評価が厳しすぎるかもしれない。ちなみに評価自体もAIに行わせている。

確認するとユーザーの指示とツール承認が同じ1回で計算されていた。そこでツール承認の重みをx0.2にすることで、バランスの良い評価が出るようになった。

vibe-coding-golfスキルのダミー結果(調整後)

紹介したスキルは以下のリポジトリで公開した。

github.com

追記1

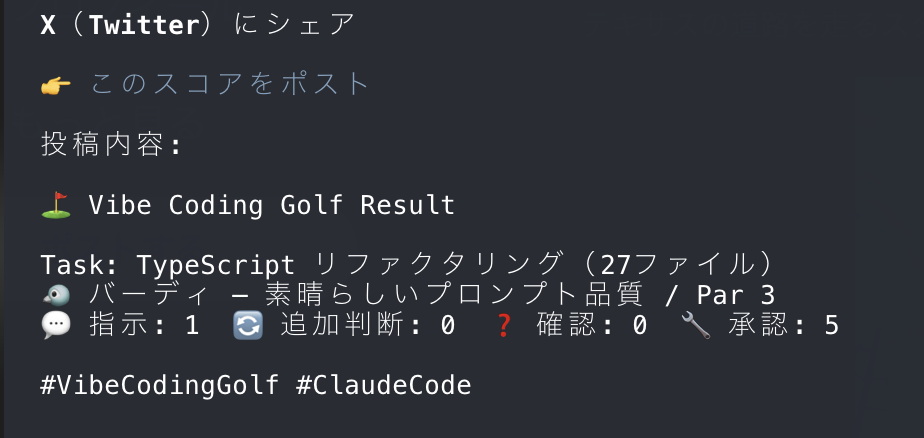
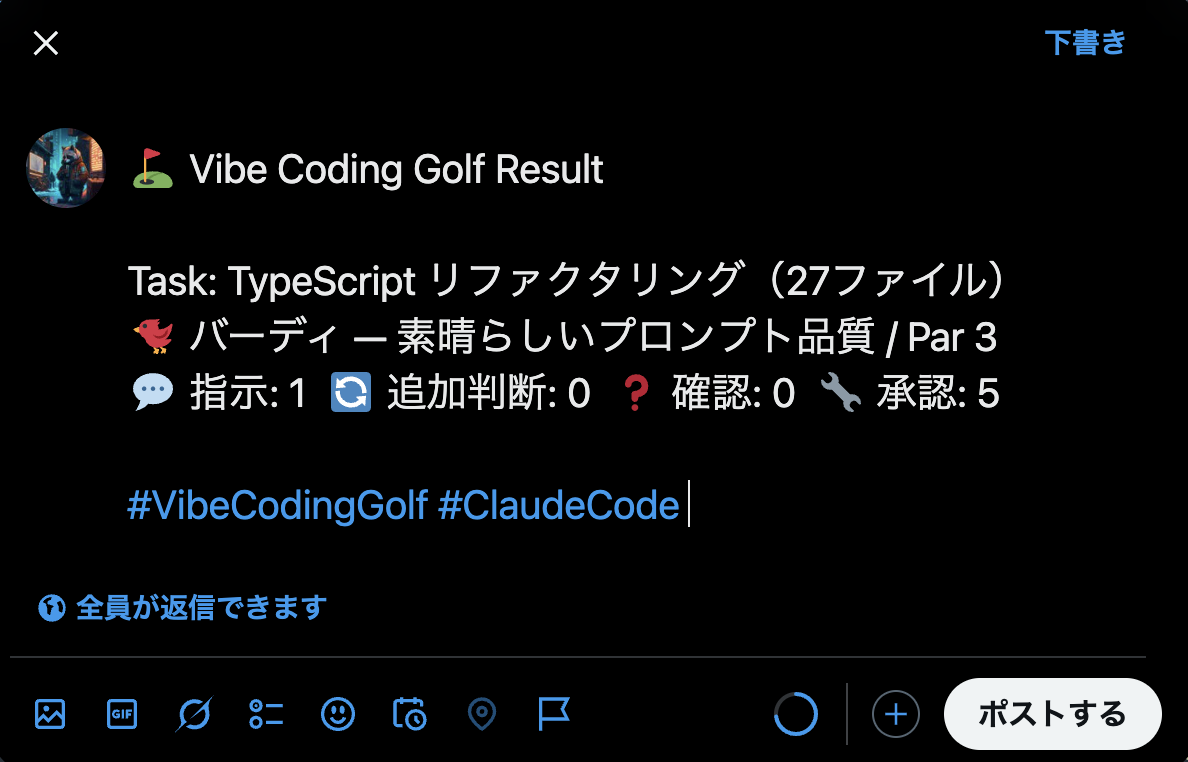
vibe-coding-golfスキルにXへのシェア機能を追加した。「このスコアをポスト」のリンクをクリックすることで投稿できる。

シェア機能を追加

Xに投稿

追記2

ツール承認は正確な値がとれないため、結局スコア計算からは除外した。

まとめ

  • コーディングAIへの指示を減らすために、Claudeとのやり取りを評価する count-interactions スキルを作成した。count-interactionsスキルをもとに、評価をわかりやすく楽しくする vibe-coding-golf スキルを作成した。
  • これらのスキルを使用することで、バイブコーディングのためのプロンプトやドキュメントの改善につながった。

大規模言語モデル講座2025応用編を修了した

去年の12月から今年の2月にかけて受講していた大規模言語モデル講座2025応用編を修了した。

nakaoka3.hatenablog.com

先日連絡があり、修了要件を満たしていたようで、無事修了の認定をしてもらえた。修了要件には出席アンケート・宿題、そして最終課題であるメインコンペで一定の点数以上を取らないといけないこともあり、修了できるか自信はなかったが、無事修了できてよかった。

最終課題のメインコンペは点数的には全く刃が立たなかったけど、0から1への経験をつめたことが自分にとっては大きい。また修了要件ではないイベントを多く催しており、それらに参加できたのも楽しい経験だった。

受講前になんとなく期待していたものよりもずっと多くのものを得ることができた。主催・運営の方々には素晴らしい機会を設けていただき、心より感謝申し上げます。

小説で学ぶ、集合から理解するTypeScriptのリテラル型【初心者向け】

去年、TypeScriptの型についての小説を書いて、そのまま放置していた。せっかくなので、少し直して公開しておこうと思う。

プログラミング初心者、TypeScriptの初心者の読者を想定した内容になっている。


登場人物

  • 私:高校2年生の女子。プログラミングと数学が好き。
  • デルタ:高校1年生の男子。プログラミング初心者。

ある日の放課後、私が高校の図書館の自習室に入ると、デルタがノートパソコンを広げたまま、手を止めて画面を見ているのが目に入った。

「なにか困りごと?」

「先輩、ちょうどいいところに来ましたね。ちょっとTypeScriptのコードを書いていたらエラーが発生していて困ってたんです」

私はデルタのノートパソコンの画面を見た。

「型のエラーが出てるね」

デルタに指示を出し、コードを修正するとエラーは消えた。

「デルタってコンパイルエラーとか、型のことわかってる?」

「わかってますよ。文字列だったら stringとか、数だったら number とか、変数につけるヒントみたいなイメージですよね」

「他には?」私は否定せずに聞く。

「後は……真偽値のbooleanとか」

デルタは宙を見つめながらTypeScriptの型を思い出そうとしていた。

「まあ、具体例は他にも色々あるよ。string, number, boolean はプリミティブ型だけど、それ以外にも配列やオブジェクトもあるよね。ほかにはanyやneverとか」

「……そういえば! TypeScriptの型について、一つどうしても納得できないものがあって...…」

デルタはパソコンのエディタを開き、次のコードを書いた。

const s: "foo" = "foo";

「TypeScriptって、こういう書き方ができますよね? これって不思議じゃないですか。型を書くところに具体的な値が書けてしまうように見えるのが、納得できないんです」

「たしかに少し分かりづらいね。確認だけど、次の定数にはどんな値を代入することができる?」

const x : number = ???

「1とか、2とか」

「そうだね。3でもいいし、4でもいい。100でもいいし、-1000でもいい」

「数ならなんでもいいってことですね。最小値と最大値はありますけど」

「その通り。では次は?」

const isOk: boolean = ???

「trueかfalseですね」

「その通り。それ以外の値は入らない。型というのは、その値がある集合の要素であるということを保証するものなんだ」

「集合って、数学の集合ですか?」

「そう。数学の集合風に表記するとこのように書ける」

私はノートを取り出し、次のように書いた。

boolean = { true, false }

「2つしかないので、外延的に書くことができるね。numberの場合はそうはいかないので、内包的に書こう。厳密な範囲までは覚えていないから、こんな感じでどうだろうか」

number = { n | 最小値から最大値までの浮動小数点で表せる数 }

「先ほどデルタは型のことをヒントのようなイメージといったけど、集合のイメージのほうが正しい」

「なるほど。型が集合だとは考えたことがなかったです」

「では、リテラル型に話を戻そう。このリテラル型を集合論の記法で書けるだろうか」

type T = "foo"

私はデルタの前にノートとペンを差し出す。デルタはペンを手に取り、少しだけ考えてから手を動かした。

{ "foo" }

「こうでしょうか」

「その通り。このリテラル型は foo という文字列のみを許容する型だ。したがってただ一つの要素 "foo" を持つ集合とみなすことができるんだ」

「あ、そういうことなんですね。型のところに値が来るのが納得できなかったんですけど、そういう書き方なだけで集合なんですね」

「リテラル型が集合だということがわかれば、Union型も理解しやすいだろう」

「Union型ってなんでしたっけ」

「Union型は集合の言葉でいうと、和集合のことだ」

「和集合って…」デルタはノートにペンを走らせ、和集合のベン図を書いた。「……このことですよね」

「そうだ。和集合が2つ以上の集合を合成してできた型であるように、Union型は2つ以上の型を合成してできた型だ。| で型を並べて書くことで Union型を定義できる。このUnion型がどういう意味か、説明できる?」

type Status = "success" | "loading" | "error"

「"success", "loading", "error" のいずれかってことですよね。あ、なるほどこれはリテラル型という要素が一つしかない集合の和集合を作っているんですね」

こうしてデルタはTypeScriptのリテラル型を理解することができ、その応用としてUnion型の記法についても理解することができた。

そして私はデルタにTypeScriptの型を説明しながら、プログラミングと数学の関係に美しさを感じていた。

(おわり)


見ての通り、数学ガールのパロディだ。数学ガールなら、この後ミルカさんが現れてより数学的な話をしてくれるのだろう。カリー=ハワード同型対応に続けるなど、より高度な内容に踏み込んでくれたら面白くなりそうだ。

AIでコーディングすることが当たり前となった今、TypeScriptの型について理解していなくてもTypeScriptのコードを書く事ができてしまう。しかし型について理解するとプログラミングについての理解がかなり深まるので、TypeScriptを触る人には理解してほしい。